从测试自动化 Workflow 到 Agent Harness 2 / 3
从直接生成到Workflow:
我一步步剥离了LLM的自由度
从最初的自由生成Test Sequence脚本,到通过三次重要的设计转变后组建Workflow。最后我成功把一个 30B 模型做成了可实际使用的 Simulink Unit Test 生成工具的一部分,同时也得到了对我未来Agent Engineering最重要的设计启示之一:对于已经能够由规则、工程数据或固定模板确定执行的部分,没有必要默认继续交给 LLM。
0. 最初的想法是在Unit Test上偷点懒
在我们公司刚从其他公司那儿接收这些应用层软件时,几乎只有Simulink模型和开发工程脚本。我当时只是一个应用层开发工程师,我们的职责除了实现功能需求外,也包含了对自己开发的模型/代码单元的测试,这也意味着我们接下来需要补充整个控制器的追溯性文件和配套工程——包括单元测试用例与单元测试工程。正巧也在26年初,大概是这项工作开始后的一两周,公司内网开始试验部署了内网LLM,一个4bit量化版本的Qwen3 Coder 30B模型。我本身也是AI聊天比较重度用户,于是动了个心思:现在已经有一部分相对规范的单元测试用例了,并且正在使用的Test Sequence有API,那我能不能在单元测试工程实现上稍微偷个懒?毕竟手动按照用例创建和调试这些测试工程有点过于无聊了。
于是我开始了第一次尝试,我直接把标准化测试需求丢给了配置好的Cline,然后告诉它我想要它为我生成一个能创建对应的Simulink Test Sequence工程的脚本,并开始期盼Cline能给出我想要的答案。Cline给了我一个273行的脚本,我扫了一眼里边有很多:addStep、addTransition等等类似的API command。这大概没啥问题,我心想直接运行吧。但第一次运行就开始报错,无法识别API command,addTransition少了个参数。我检查脚本后,告诉了Cline正确的API用法并让它再次尝试,依然报错,这次又是把一个float值赋给了uint8变量。继续修改,继续报错......
这么反复折腾几次后,我开始意识到这个问题应该没那么简单,我似乎低估了Simulink Test Sequence这类比较冷门的API对于一个30B模型的复杂程度。
1. 不再让模型直接生成Case构造脚本
我并没有因为前边的失败就放弃了我上边的偷懒想法。在查询资料后,我找到了一个在我看来足够有趣的问题:我看到了Qwen3 Coder 30B模型完成了pytest测试的案例,而Simulink Test本身也是一个测试框架,从意图上说,这是一类任务场景;我当时据此形成了一个假设:模型也许并不是完全缺乏“根据测试描述构造测试逻辑”的能力,真正阻塞它的可能是 Test Sequence 的领域 API、工程数据和任务形式。因此,与其立即把失败归因于模型能力不足,我更想看看能否通过重构模型外围的流程降低任务难度。
从前边的调试错误来看,其实大概可以分成两类:API Command类型的错误(例如addTransition)和测试描述内容的知识性错误(把u8量当成了float去赋值)。这些问题中有一部分是可以用脚本直接解决的问题,所以我决定直接增加一个数据处理环节,并且将LLM输出限制成JSON以便后续脚本校验,最后再输出成特定格式的.m脚本(用于构造Test Sequence),而不是继续修改Prompt。在我的预想中,数据处理将会把LLM返回的不合规的、有问题的数据进行校验和处理,特定格式的.m脚本会把一部分容易错的API Command写死,这样能解决很大一部分的Test Sequence构造脚本报错问题。
其实在现在看来,这个解决措施更像是把一个开放式代码生成问题,缩小成一个有限 schema 的结构化映射问题。
2. 第一个转变:给LLM的任务“降维”成填空
分析之前的失败模式,我当时怀疑,一次性要求模型承担过多职责,是失败的重要原因之一。LLM需要一次性完成:需求的语义理解、测试语义转化、Test Sequence序列设计、Test Sequence API使用、DataType判断等等。所以第一件事情就是给LLM的任务降维:尽可能只负责测试自然语言与代码化逻辑的转化,不再直接关注 Test Sequence的API调度正确性。
2.1 LLM的输入依然是测试需求
这里LLM输入的内容依然是之前工作中准备好的测试需求描述文本,不过在经过一天左右的提示词输出调整后,相比以前会更结构化一些。由于保密要求,这里做了一部分匿名化处理,变成了一个更一般的描述
以下为匿名示意,非真实工程用例,也不可直接执行。名称、数值与占位符仅用于说明输入结构。
测试名:TC001(匿名示意)
测试目的:说明输入激励、等待条件与输出期望的表达结构
Harness:Torque_Control(示意名称)

标定量(Calibration,与运行时 Signal 区分):
- calibration1 = <由原始需求提供>
- calibration2 = <由原始需求提供>
- calibration3 = <等待阈值及单位,由原始需求提供>

信号(Signal):
- SWC_bool_signal1:功能使能信号
- SWC_s16_Pedal:踏板输入信号;60、80 仅为示意激励值
- SWC_Nm_Torque:输出扭矩,单位 Nm

步骤 1:
- SWC_bool_signal1 = true
- SWC_s16_Pedal = 60
- 等待超过 calibration3 所指定的时间

步骤 2:
- SWC_bool_signal1 = true
- SWC_s16_Pedal = 80
- 期望 SWC_Nm_Torque = <需求中的期望值,单位 Nm>
- 验证时机及容差:<由原始需求确认,本示意不补写>
2.2 LLM不再直出代码,而是输出JSON
调整后的期望的LLM输出形式大概是下边这样:
// 结构示意,含注释与省略内容,非可执行 JSON

{
  "name": "TC001",              // Test Case Name
  "harness": "Torque_Control",  // Test Harness对象
  "symbol": [...],              // 测试需求中涉及到的calibration量
  "init": [...],                // 测试需求中的初始条件(前置条件)
  "steps": [                    // 序列化的测试步骤
    {
      "input": [...],           // 输入信号的激励值
      "expect": [...],          // 期待验证的结果(对应verify语句)
      "time": {...}             // 时间跳转的逻辑
    }
  ]
}
除了上边这些内容外,还有一些其他的字段
- isenum;标识当前signal/calibration是否为enumeration量
- compare operator;标识当前输出的比较类型是==、>、<、>=或者是<=
- tolerance;标识当前输出的容差范围,分为绝对容差和相对容差两种
- DataType;标识当前signal/calibration的数据类型
这里数据结构设计的最重要依据是便于后续的数据清洗和脚本构造,并且我没有向LLM解释为什么这样设计schema;LLM只看到字段定义、填写规则和 few-shot example,并按 schema 填写结果。例如symbol的声明、harness的声明、compare operator的选取、tolerance的声明等等。
最后其实针对这套schema还做了一个精简化的改进,因为整个LLM的context size只有64K,在当时的提示词和字段展开方式下,部分长用例可能逼近部署配置的上下文上限。所以最后很多key值都被缩写为更精简格式,或者无输出时直接隐去。
2.3 JSON变成了语义中间层
坦诚地说,当时我没有“设计 IR”这个概念。我只是发现直接生成 Test Sequence 构造脚本太不稳定,于是把模型的任务变成了:按照自然语言描述,填写一个受限 JSON。
现在回头看,这一层实际上已经很像一个面向测试领域的中间表示层。
LLM成为了最后Workflow中JSON中间层数据的生产者,后续的DATA CLEAN、REVIEW都是围绕这个中间层数据的清洗、处理与审核,最终整个中间层数据在RENDER环节被消费为真正的Test Sequence构造脚本。
3. 第二次转变:查询工程事实,而非‘推理’
在最开始,数据处理只是为了将缩减后的LLM 返回的原始JSON值还原成标准格式,并对后续构造测试脚本所必须的字段进行校验。但在反复调试LLM环节后,我发现交给LLM的任务依然太重了,或者说一部分任务并不适合交给LLM。例如数据类型的判断。
3.1 LLM的“理解”不等于工程事实
这个问题是在第一次给LLM任务降维后的调试过程中发现的。
主要是对DataType的识别错误:我们的signal/calibration是可以直接从命名推断出来数据类型的,事实上刚开始我也是让LLM去推理的,但效果并不理想。例如一个信号名为SWC_s_DlyTime, LLM可能会猜出来sint16或者uint16,又或者uint8等等数据类型,即使我已经在prompt内约束了命名与数据类型的对应规则,但是模型依然会经常犯错。
而实际的工程规则中,我们会有对应calibration表格来专门管理,包括数据类型。除了从命名规则推断外,更为精确的方法就是直接查询数据表格。显而易见的是,这里应该直接查询calibration的数据类型,而不是让LLM根据规则去自行推理数据类型。
基于此,我在数据处理环节多引入了一个新的职责:基于已有数据源,去查询和纠正LLM填写的JSON中间层的一部分数据。这部分后文也统称为Data Adapter。
3.2 数据处理环节的职责
补充后的数据处理环节需要做如下处理:
- 展开缩写字段;
- 补齐LLM略过的字段;
- 检查数据类型、输入激励是否缺失;
- 根据已有数据表纠正匹配的数据类型;
- 做后续模板需要的文本预处理;
- 为 calibration 创建 shortname,避免 Test Sequence symbol 和 Base Workspace 对象重名。
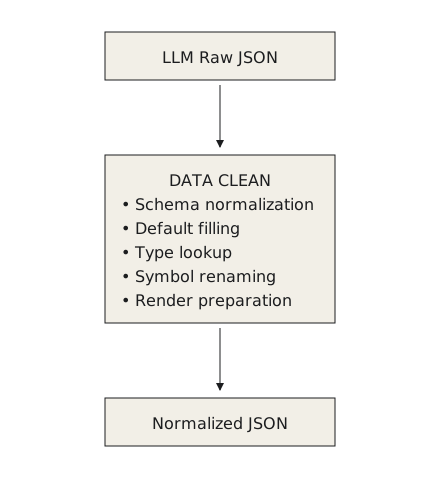
整个数据处理环节可以看作是对LLM返回值的校验和标准化处理,并为JSON中间层数据被消费为Test Sequence脚本做准备。
3.3 数据处理的边界
这个思路下的数据处理有一个前提:足够的工程基础设施环境。
细心的读者应该发现,我在给数据处理引入新职责时,只是让它查询并纠正LLM填写的JSON中间层数据,并没有把LLM判断DataType的职责从LLM内划出。这是因为我们工程的基础设施有所欠缺;所有的calibration量被划归了数据表管控,但是还有signal这类数据对象并没有一个完整的数据表进行管控:
- Calibration: 基本查得到
- OutPort Signal: 部分查得到
- InPort Signal:完全查不到
这也是我保留LLM推理数据类型职责的最重要原因:当前的工程基础设施并不足以支撑Data Adapter完成所有的calibration/signal的DataType纠正,一部分数据的DataType的最终确认还是得落在人工审核上。
故此我选择了在数据处理时增加了一个source字段,Adapted表示当前对象的数据类型已经被 Adapter 从已有工程数据源中匹配并覆写;LLM guess 则表示该 DataType 尚未通过工程数据源确认其数据类型,需要在 Review 阶段重点确认, 并且控制台会打印一个warning,内容是无法被Adapter匹配到的signal/calibration量。
由此也引申出来一个结论:结构化工程数据的覆盖程度,会限制多少模型推断能够被替换成基于工程数据的校验。 这个结论在第5节的增量对照试验中也有异常样本数据可以论证。
基于上一个结论,可以迁移到其他工程中的一条设计经验是
对程序不可查询的工程事实,可以保留模型推断,并交由人工确认
当然,从后来的工程经验中回顾,更强的模型确实可以缓解‘数据类型识别成功率低’这类推断错误。我后来使用 GLM 5.2 时,可以观察到 DataType 判断明显稳定了一些。但这并没有改变这里的工程原则:如果真实类型已经存在于工程数据源中,就没有必要让模型重新猜一次。而在受限LLM能力的前提下,除了改造LLM的外围代码设施外,对已有基础环境的改造也是一件同样重要的事。这个问题我们可以在未来更有对比价值的场景下去进一步探讨。
4. 第三次转变:Test Sequence控制序列由模板固化
在完成数据处理-人工检查后,被校准过的JSON数据将会通过渲染器和准备好的Jinja2模板进行渲染。这个设计除了隔离LLM对Test Sequence API的使用推理外,也隔离了LLM对Test Sequence序列设置的推理。通过固化的Test Sequence Step模板,降低了LLM的任务负担。
4.1 为什么不让 LLM 直接组织 Test Sequence
除开本身这个30B LLM能力有限,Test Sequence API较为冷门外,最主要的原因还是在于Test Sequence同时包含了多个自由度:
- 激励信号设置的自由度;
- 时间设置的自由度;
- 评估信号设置的自由度;
- 测试Step/SubStep跳转的自由度;
- 测试序列结束条件设置的自由度;
这个自由度的调整区间太大,在当时的模型智能、提示词设计和执行方式下,我无法让模型稳定同时兼顾这些逻辑。实际在调试阶段中,针对同一个测试需求文本,LLM应答的控制流设计也各不相同,而序列设置错误会导致最后生成的脚本运行也会报错。所以干脆将这部分控制流设计从LLM的职责中划分出来,人为抽象一个通用模板。
值得一提的是,后来的 Agent 实践也给了我一个有意思的对照:即使LLM更强,并且 Agent 能看到 API 执行反馈,这类 Test Sequence 控制流任务依然经常需要多轮调试。这不能单独证明问题来自控制流自由度,但至少说明,“换更强模型 + 增加执行反馈”并不足以自动解决这类任务。
4.2 一个 Step 的固定执行模板
人为抽象后的单个Step长这样,一个Main Step对应测试需求中的一个Step:
这里我相当于每一步都做了单个测试Step的最大展开:
- 固定每一个Step都有输入激励信号MainStep,若没有则沿用上一个Step的设置
- 固定每一个Step都有时间等待SubStep,若没有说明则默认delay一个SWC的调度周期 (这是兜底规则;若涉及更长响应时间的测试,仍需显式填写等待条件)
- 固定每一个Step都有评估SubStep,若该 Step 没有期望结果,则不生成断言,继续执行后续步骤
- 每个 Main Step 设置输入激励,并依次经过 Time、Verify、End 三个 SubStep;End 设置
end_step,允许切换到下一个 Main Step
或许有读者会问:假设我一个测试的后续Step依赖于前序Step的状态,可能要做Step_A->Step_B和Step_A->Step_C的跳转判断怎么办?
在这里我的答案是:对于能够独立枚举、且拆分后不改变测试语义的分支路径,我选择从测试描述阶段就把这两个不同的跳转逻辑写成两个不同的测试需求,从输入层面配合这个Step模板,把多条件的复杂度处理从Test Sequence模板转移到测试需求的书写上。
这是一个明确的 trade-off:我把 Test Sequence 内部的分支复杂度转移到了测试需求设计阶段,换取更规则、更容易生成的执行结构。
4.3 冗长,但生成正确率更高
对熟悉 Test Sequence 的工程师来说,这种结构很笨:很多本来可以更直接表达的逻辑,被统一展开成 main → time → verify → end的循环,并且Test Sequence很多高级且好用的语法都没有使用上。
它不优雅,但对LLM来说足够简单和直接。
这套方法很笨,但在后续测试和实际使用中,这套固定模板基本消除了我此前反复遇到的那类 Test Sequence 控制流错误,也明显减少了因此产生的脚本调试工作。这其实也给我一个工程设计上的启示:
有时候工程系统的目标不是生成最漂亮的结果,而是生成最容易保证正确的结果。
5. 增量对照:这三次设计转变真的有用吗?
在当时设计这个Workflow时,我并未严格量化验证过上述的三个设计措施对于整个Task的影响。所以在这篇博客中,我特地加入了后验性的增量对照实验,验证我半年前设计的合理性。
5.1 实验问题
通过增量对照实验,明确以下三个设计在多大程度上改善了Workflow单次运行生成可直接运行的Test Sequence脚本的成功率:
- 结构化LLM的输出以隔离API使用错误影响;
- 引入Data Adapter以降低DataType类错误;
- 引入固定控制流以降低 Test Sequence控制流错误。
5.2 实验设计
任务的对象是我实际工作中,某一版本软件变更涉及到的4个软件模块,对应新增了21例Unit Test测试需求文本。 各组使用相同模型(Qwen3 Coder 30B)、量化配置(4bit量化版)和默认生成参数。 每个Unit Test测试需求文本仅进行一次生成,每次生成都会单独请求一轮LLM
实验指标如下:
- First-pass Success:不经过人工修正,一次直接生成可运行且测试语义正确的测试脚本的数量
- Syntax/API:由语法/API引起脚本运行报错的数量
- DataType:由数据类型错误引起Test Sequence运行报错的数量
- Control Flow:由序列控制引起的Test Sequence运行报错/Fail的数量
- Semantic Fail:生成的测试与需求语义不一致的 Case 数量,由序列检查和仿真结果共同判定,包括输入值、期望值、断言遗漏和验证时机错误;不以仿真是否返回 Fail 为唯一依据。
注:Syntax/API 类错误主要在脚本执行、Test Sequence 创建或模型更新阶段暴露;DataType 类错误在运行阶段暴露;Control Flow 与 Semantic Fail 则结合序列检查和仿真结果判定。故此对于存在基础Syntax/API问题的Case不适用Semantic Fail 的运行判定这个指标。
另外,实验屏蔽了人工Review环节:
- Baseline对应最初的LLM直接生成Test Sequence脚本,仅在提示内部提供few-shot以供参考
- Structured对应将LLM的数据进行结构化后配合数据处理、渲染器生成Test Sequence脚本的Workflow,不包含Data Adapter和固定Step序列控制的渲染模板
- + Adapter对应Structured版本外加激活Data Adapter的功能,不包括固定Step序列控制的渲染模板
- + Fixed Control对应+ Adapter外加固定Step序列控制的渲染模板,这里基本接近完整的Workflow
5.3 实验结果
表 1 最终 Outcome
| Variant | First-pass Success | Success Rate |
|---|---|---|
| Baseline | 0/21 | 0% |
| Structured | 4/21 | 19.0% |
| + Adapter | 2/21 | 9.5% |
| + Fixed Control | 18/21 | 85.7% |
表 2 Failure diagnostics(可重叠)
| Variant | Syntax/API | DataType | Control Flow | Semantic Fail |
|---|---|---|---|---|
| Baseline | 20 | 7 | 20 | 1 |
| Structured | 0 | 7 | 12 | 17 |
| + Adapter | 0 | 1 | 13 | 18 |
| + Fixed Control | 0 | 0 | 0 | 3 |
注Failure diagnostics 为非互斥标签,一个 Case 可能同时存在多个错误类型,因此各列之和不等于测试用例总数。
5.4 分析与结论
最终4组实验的一次生成成功率柱状图如下:
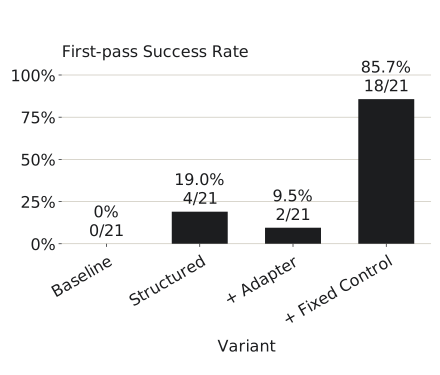
这里我们还需要对四组实验的具体Failure diagnostics进行分析,否则单从First-pass Success Rate这个指标很容易得出错误结论。
Baseline组
这组不用多说,除Semantic Fail外,剩余三类错误指标明显高于其他三组。唯一一例没有出现Syntax/API的Case在Semantic Fail上也是存在问题的,基本等同于在当前LLM的能力下很难直接生成可运行且语义正确的测试脚本。
Structured组
相比起Baseline组,Structured成功将 Syntax/API 类错误从20降低至0,后续的 + Adapter 组以及 + Fixed Control 均未出现 API/Syntax 类的能力退化,可以认为Structured JSON + deterministic renderer 基本消除了实验中的 API/Syntax 类错误。一次生成成功数量从 0 例增加到 4 例,但整体成功率仍然较低。因为这个方案没有自动解决 DataType、control flow 和测试语义匹配度的问题。它解决的是“如何可靠生成合法脚本”,不是“如何保证测试语义正确”。
+ Adapter组
这组看起来最有迷惑性:相比起Structured组,First-pass Success Rate反而下降了,并且 DataType 类型错误依然存在(7 -> 1)
在实际分析和复测退化的样本Case时,我发现:
- 一例Structured组内First-pass Success被判定为Pass的样本 Case 首轮曾成功,但在两种配置(Structured组和+ Adapter组)下各复测 5 次均失败,说明首轮成功不能代表它能够可靠生成。
- 一例+ Adapter组内DataType类型错误正好对应上了‘LLM类型推断错误+无基础数据表供Adapter查询’的问题。这例样本在+ Adapter组环境下复测了5次,DataType类型错误只出现了1次;我更新数据表后又复测了5次,5次全部Pass
所以实际上这组的结论应该是:
Adapter 把已有工程数据能够确认的一部分 DataType 推理转成确定性查询,使 DataType 类错误从 7 例降到了 1 例;补齐数据源后,该例 DataType问题样本 Case 在五次复测中均通过。并且局部复测显示,首轮结果存在生成波动,但不足以完整解释整体成功率下降。当前更明确的观察是,DataType 类错误从 7 例减少到 1 例,而First-pass Success Rate没有同步提高。
+ Fixed Control组
固定控制流是这组实验中对Control Flow类错误影响最大的组件。在当前 21 个测试需求上,Control Flow 类型的错误从 13 例降为 0。
进一步查看失败样本发现,LLM 自由组织控制流时一个高频错误(10/13)是修改激励后立即验证,而固定的 Input → Time → Verify 模板直接消除了这一类自由度。+ Adapter 组另外三例原因各不相同的Control Flow错误(例如时间跳转逻辑存在问题等等)的样本Case,在这次试验中无法统一归类,就暂不体现了。
综合结论
从这几组实验对照我们可以看出来,三次设计转变分别解决了不同的问题。在本次增量对照中,包含三项设计的完整配置取得了最高的一次生成成功率;不同配置下的错误分布,也与各项设计针对的失败模式基本一致:
- Structured Output减少了30B LLM对冷门API使用的语法错误,让Test Sequence构造脚本达到“可运行”状态。
- Data Adapter基于能查询到的工程事实,改善了30B LLM对变量数据类型推理错误的问题。
- Fixed Control 将控制流组织交给固定模板,在本次样本中消除了过早验证及其他已观察到的控制流错误。
这些结论共同指向了我后来做工程型 Agent 时反复采用的一条设计原则:
对于已经能够由规则、工程数据或固定模板确定执行的部分,没有必要默认继续交给 LLM。
6. 从单个 Case 到完整 Test File
前边的 ‘INPUT->LLM->DATACLEAN->REVIEW->RENDER’ 其实已经解决了“如何创建一个 Case”,但是单个Case并不等于测试工程。
单个 Case 的生成完成后,还需要将多个 Case 组织进 Test Manager。ASSEMBLE 负责建立 Test File、Test Suite 和 Test Case,配置 Harness 与标定覆盖,并处理初始化、清理及单个 Case 的集成失败。这部分主要处理测试工程的组织与运行环境。
在最开始设计这套Workflow时,代码工程复杂度的增加主要还是聚焦于核心业务的需求:文本解析 → LLM → 数据处理 → 模板渲染。
而到这个阶段,代码解决的问题开始慢慢转向了工程环境的管理上。
7. 最后,LLM只剩下了一件事
最终完整的Workflow示意图如下
回顾整个Workflow的设计,其实就是在把不需要推理能力的任务从LLM上一点点剥离:
- Test Sequence API 容易调用错误,就不再让模型直接生成 API 调用;
- 数据类型存在已有工程数据,就尽可能交给 Data Adapter 查询和校验;
- Test Sequence 的控制流太自由,就用固定模板把它收敛成 Main → Time → Verify → End;
- 多个 Case 如何进入一个可持续维护的 Test File,则进一步交给 ASSEMBLE 处理。
LLM 真正保留下来的核心职责只剩下一件事:把自然语言测试需求转换成一份受限的结构化测试表示。
到这里,测试需求已经能够经过受限的结构化转换、工程数据校验和模板渲染,进入完整的测试工程。但生成链路跑通之后,工具的可用性与维护成本仍有其他问题需要解决。下一篇继续复盘这些工作:哪些必要,哪些后来证明属于过度工程。